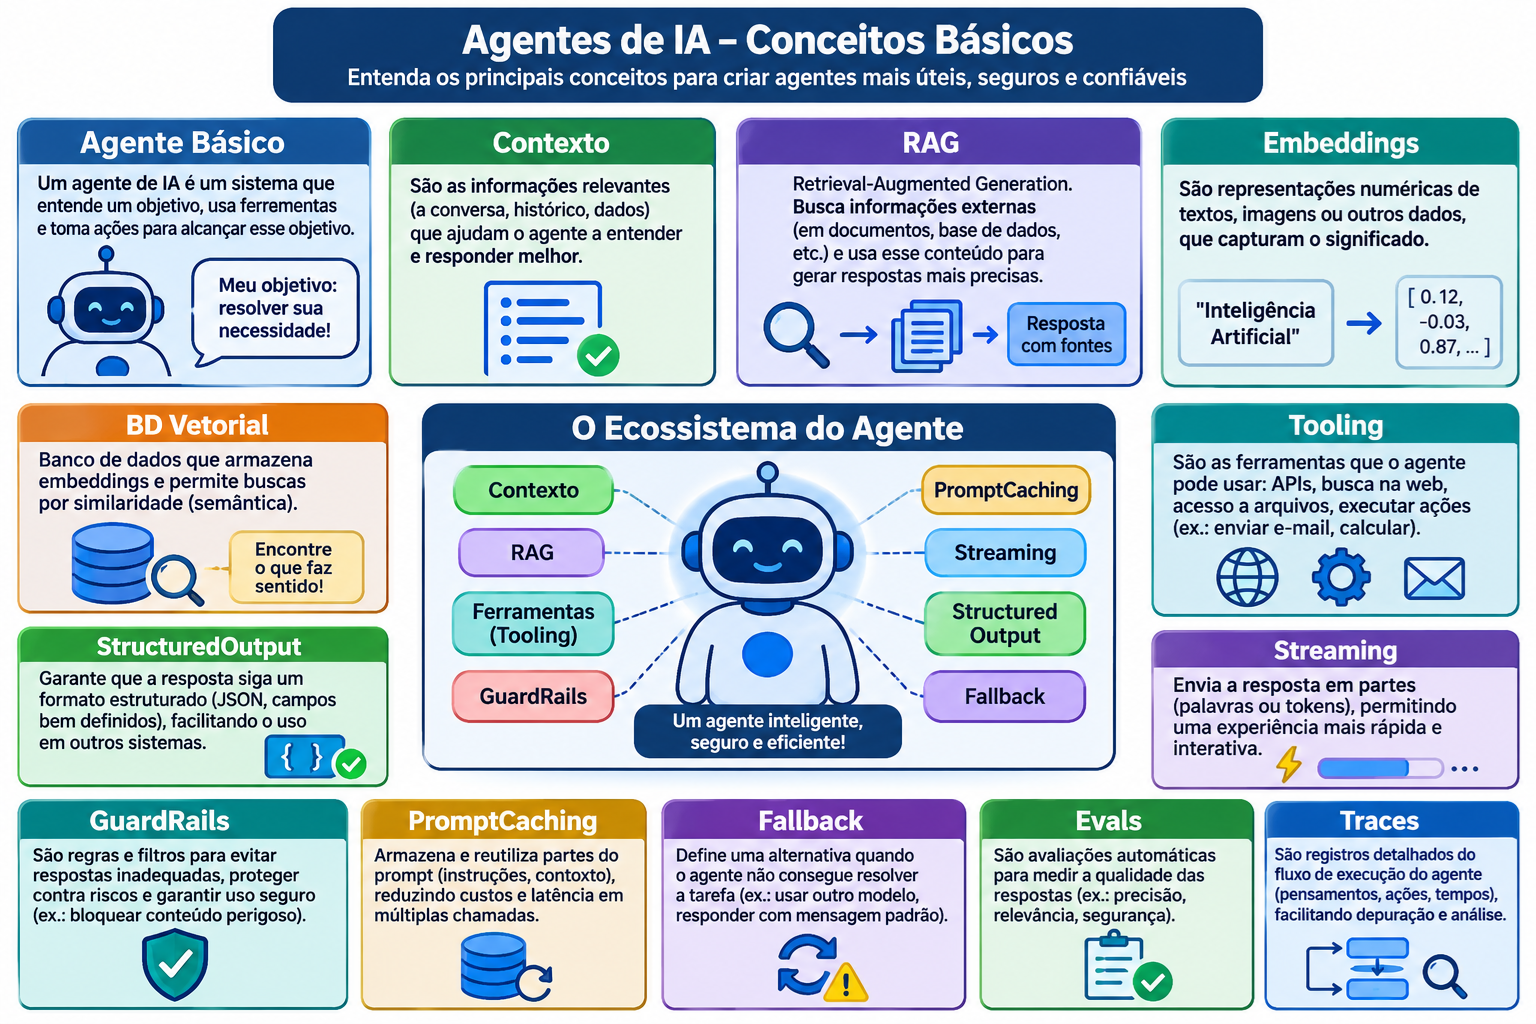
Você já criou um agente de IA ?
Enquanto roda de maneira provisória tudo parece simples mas na hora de colocar em produção para toda a empresa a coisa pega.
Fica lerdo, não responde, trunca a resposta, etc.
Motivos para criação do Agente.
Normalmente criamos um agente de uma maneira simplória e conforme a necessidade vamos incorporando novas funcionalidades
visando atender melhor às necessidades dos usuários.
Contudo raramente criamos um agente de IA com todos os componentes que ele pode ter, mas numa entrevista ou
reunião podemos ser questionados sobre um componente de um agente de IA que nunca ouvimos falar quanto
mais usou ou programou.
Vamos mencionar neste documento todos os componentes e porque eles existem dentro do agente.
Começamos com um simples chat.
Café com leite. Você criou uma interface para coletar as opções do usuário e processá-las.
Vamos começar com uma coisa bem simples, um chat com RAG.
Você pega as opções do usuário, envia para a IA, a IA processa e retorna a resposta.
Aí você exibe a resposta para o usuário.
Criando um Contexto para o Agente.
Na segunda pergunta que você faz a IA , ela não lembra da primeira pergunta.
Para resolver isso, precisamos criar um contexto que mantenha a memória das interações anteriores.
O contexto é fundamental para que a IA responda levando em conta as interações anteriores senão ela fica parecendo um cara com alzheimer e dando as mesmas respostas mesmo quando falamos para ela que não é aquilo que queremos.
Direcionando a resposta para o que desejamos. Conceito RAG
Você faz uma pergunta para a IA sobre sua empresa e a IA responde consultando a Internet e não obrigatoriamente irá originar a resposta que desejamos que o usuário receba porque a IA conhece a Internet mas nada da sua empresa.
Sendo assim criarmos um conjunto de documentos com as respostas desejadas e enviamos para a IA
Assim sendo a resposta da IA será guiada pelos documentos enviados.
Chamamos essa pesquisa de RAG (Retrieval Augmented Generation) que é uma técnica de IA que combina a geração de
texto com a recuperação de informações relevantes de um conjunto de documentos.
Flexibilizando a pesquisa. Conceito Embeddings
Ótimo, você colocou a resposta desejada no documento e o cliente ai faz a pergunta errada.
Por exemplo, no documento você colocou a resposta para a pergunta "Cancelar a assinatura ?" e o cliente pergunta
"Encerrar minha conta".
Os embeddings são representações numéricas de palavras ou frases que permitem que a IA compreenda melhor o significado e as relações entre os termos fazendo com que diversos formatos de pergunta sejam direcionados para a mesma resposta.
E quando são muitas respostas ?. Conceito de Banco de dados Vetorial
Você tem uns 200 documentos com informações da empresa e subiu todos eles para a IA.
Contudo ao fazer a pesquisa a IA tem que varrer todos os documentos para encontrar a resposta desejada e isso
fica muito lerdo.
Sendo assim criamos um banco de dados vetorial e nele colocamos todas as respostas que desejamos
criando e organizando os embeddings de forma eficiente, permitindo buscas rápidas e precisas.
A IA está respondendo um chat. E quando ela precisa fazer algo mais? Conceito de Tool Calling
No exemplo acima o cliente pediu para cancelar o pedido.
Nesse momento precisamos que a IA além de responder o chat, faça uma ação no sistema da
empresa para cancelar o pedido, ou seja, chame uma ferramenta específica para realizar essa tarefa.
Sendo assim criamos um conjunto de ferramentas para auxiliar a IA a atender o usuário.
Criamos assim um recurso chamado Tool Calling que a IA irá chamar quando precisar executar uma
tarefa específica que não é da natureza do chat.
Citando um exemplo envio uma imagem para a IA e faço uma pergunta. Para ela responder precisa, por exemplo,
fazer o OCR (transformar de imagem para texto-Optical Character Recognition) e depois pesquisar no texto
extraído da imagem.
A IA faz muito disso, procurar por ferramentas que façam o que ela não consegue. O mais comum é a IA ir em outra
IA que faça a tarefa que ela não consegue.
A IA está respondendo um chat em texto simples, mas preciso que a resposta seja feita no formato JSON. Conceito Structured Output
Este caso ocorre quando você faz uma pergunta para a IA e precisa que a resposta seja estruturada em um formato específico, como JSON, XML, CSV ou outro formato de dados.
Sendo assim a IA precisa 'converter' a resposta para o formato solicitado. Isto é chamado de Structured Output e é útil quando você deseja integrar a resposta da IA com outros sistemas ou aplicativos que exigem um formato de dados específico.
A IA está respondendo e o texto da resposta é muito longo ou exige um processamento pesado e no meio
da resposta a conexão cai e você fica sem o resultado correto.
Para evitar esse problemas tempos o recurso Streaming
Quando a resposta é longa ou com um processamento pesado é bom ir enviando o que está sendo gerado para pelo menos informar ao usuário esperar terminar o processamento retirando a impressão que o processo está travado.
Sendo assim a IA vai enviando a resposta conforme obtém uma parte da resposta, aos poucos, como um streaming de video.
O usuário (vendedor da loja) pergunta como foram as vendas do Mês? Ele deve visualizar as vendas de toda a empresa ou só as dele? Criando um contexto mais restritivo temos o recurso GuardRails
A IA numa resposta entende que tem que tem que enviar a resposta completa para todos os clientes
quando o correto seria enviar a resposta cabível aquele cliente específico.
Normalmente isto está restrito ao perfil do cliente pois um vendedor não pode ver as vendas de outro vendedor
mas o gerente de vendas pode.
A resposta a um cliente demandou um grande processamento e a resposta foi longa. Um outro cliente faz a mesma pergunta e a IA tem que processar tudo novamente? Criando o recurso Prompt Caching
O prompt caching é um recurso que permite armazenar em cache as respostas geradas pela IA para prompts
específicos ou pelo menos para as partes que nunca mudam na resposta.
Você sabe que se a IA cair vai ser sempre no pior momento, certo? Para previnir essa catastrofe criamos o recurso FallBack
O recurso fallback é uma estratégia de contingência que permite que o sistema continue funcionando mesmo quando a IA(a) não está disponível ou falha em fornecer uma resposta adequada e podemos passar o processamento para outra IA(b).
Neste caso o segredo é detectar o problema e fazer com que a IA(a) responda igual a IA(b).
Você alterou uma picuinha e um monte de respostas que antes estavam OK agora estão totalmente erradas. Para previnir esse erro temos o recurso Eval
O recurso eval é uma ferramenta que permite avaliar e monitorar a resposta e o desempenho da IA, identificando quando as respostas estão fora do padrão esperado ou mesmo quando a IA alucinou.
O bom deste recurso é que se o erro for detectado por nós ou pelos clientes este recurso irá informar da mesma maneira e podemos atrelar a essa 'detecção de erros' um recurso que automaticamente faz a correção.
Você recebeu uma reclamação de um cliente importante informando sobre um erro numa resposta.
Para apoiar na depuração do erro ocorrido temos o recurso Traces ( ou Logs )
O recurso traces permite salvar as respostas geradas pela IA de maneira que podemos fazer a análise posterior.
Muito útil na fase de testes e aceitação mas pode ficar inútil em produção se não colocarmos um filtro nos traces a serem 'trapeados'.
Como disse no inicio é muito raro a gente criar um agente com todos esses recursos mas se precisar você sabe que eles existem.